C-Eval
中文综合学科能力评测基准。
FlagEval是北京智源人工智能研究院提供的AI 模型评测入口。智源的大模型评测平台。本页只介绍如何从官网使用它,不替代官方文档。
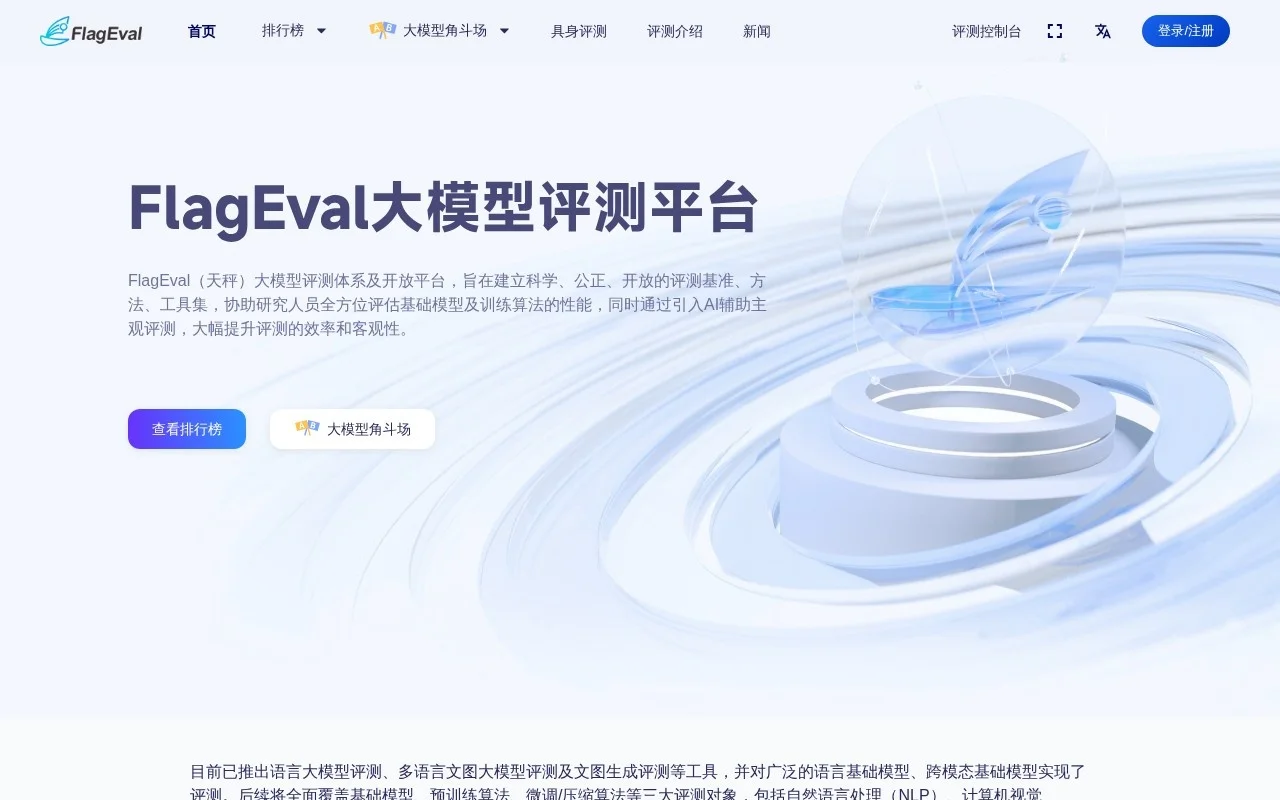
FlagEval 是智源的大模型评测平台。使用前应区分它和同一机构的其他产品,避免把聊天、开发平台、模型社区或设计工具混成同一个网址。
FlagEval适合先完成一个小任务来判断效果。生成式结果可能包含过时或不准确的内容,对外发布、学术提交、商业承诺和代码合并之前都要人工核对。账号权限、价格和可用地区以https://flageval.baai.ac.cn/当天页面为准。
它主要给需要“智源的大模型评测平台”的人使用。已经有明确成品流程的团队,可以把它放在草稿、检索或预处理环节,而不是直接当作最终交付。
下面是本导航中用途接近的网站,可以按具体任务比较,而不是只看名称:
Q:榜单第一就能用于生产吗?
A:不能。业务数据、成本和延迟都要单独测。
Q:分数会过期吗?
A:会。模型更新后旧分数不再代表当前版本。
Q:从哪里进入官网?
A:使用本页按钮打开 https://flageval.baai.ac.cn/。如果网址跳转或功能改版,以官网当前页面为准。
本文根据公开产品信息整理,功能与价格可能变化。